 Stacjonarne
 Mobilne
 VR i AR
 EEG
 fNIRS
 Sygnały obwodowe
Ruch i struktura wizyty
Wejścia, ścieżki, mapy gęstości, strefy pomijane, czas wizyty, kolejność kategorii, powroty do tej samej półki.
Narzędzie zamienia obraz z kamer w zagregowane wskaźniki zachowania: po co klienci przychodzą, co ich zatrzymuje przy ekspozycji i które materiały w sklepie zbierają uwagę. Modele wizyjne pracują na urządzeniu w sklepie, a wynikiem są zdarzenia ze znacznikiem czasu. Wdrożenie zaczynamy od pilotażu w dwóch sklepach.
Ten sam zapis obsługuje wszystkie moduły. Zakres uruchomiony w danym sklepie zależy od pytania zamawiającego i od tego, co obejmują istniejące kamery.
Wejścia, ścieżki, mapy gęstości, strefy pomijane, czas wizyty, kolejność kategorii, powroty do tej samej półki.
Misja zakupowa odczytana z przebiegu zachowania, wielkość grupy, pora i kontekst wizyty. Wyłącznie w postaci zagregowanej.
Zatrzymanie, zwrot ciała i głowy, sięgnięcie, odłożenie produktu, porównanie dwóch opakowań, czas decyzji.
Kontakt wzrokowy z materiałem POS i ekranem, liczba kontaktów, czas patrzenia, udział w uwadze strefy.
Długość i dynamika kolejki, czas oczekiwania, rezygnacje z zakupu, wybór kasy samoobsługowej.
Braki na półce, zaburzony planogram, zablokowane przejście, zgodność ekspozycji z ustaleniem handlowym.
Granica między warstwami mówi, co opuszcza sklep. Obraz jest przetwarzany na miejscu, a na zewnątrz wychodzą ustandaryzowane zdarzenia bez cech osobowych. Dzięki temu ten sam model pracuje w sklepie z trzema kamerami i w sieci z tysiącem lokalizacji.
Kamery sufitowe sklepu i moduł przy nośniku reklamowym. Obliczenia prowadzone lokalnie, bez transmisji obrazu.
wyjście: klatki i strefyDetekcja i śledzenie osób, trajektorie, poza ciała, kierunek głowy, dłoń przy produkcie.
wyjście: sygnałyModel wizyjno-językowy opisuje epizody zachowania: zatrzymanie, wahanie, sięgnięcie, rezygnację.
wyjście: zdarzeniaPołączenie zdarzeń z danymi kasowymi i planogramem, zapytania w języku naturalnym, raporty okresowe.
wyjście: wskaźnikiPo lewej ujęcie wyjściowe, po prawej ten sam kadr po wyznaczeniu stref ekspozycji. Z tego materiału model odczytał trzy sylwetki, sześć stref i dwa pobrania produktu.
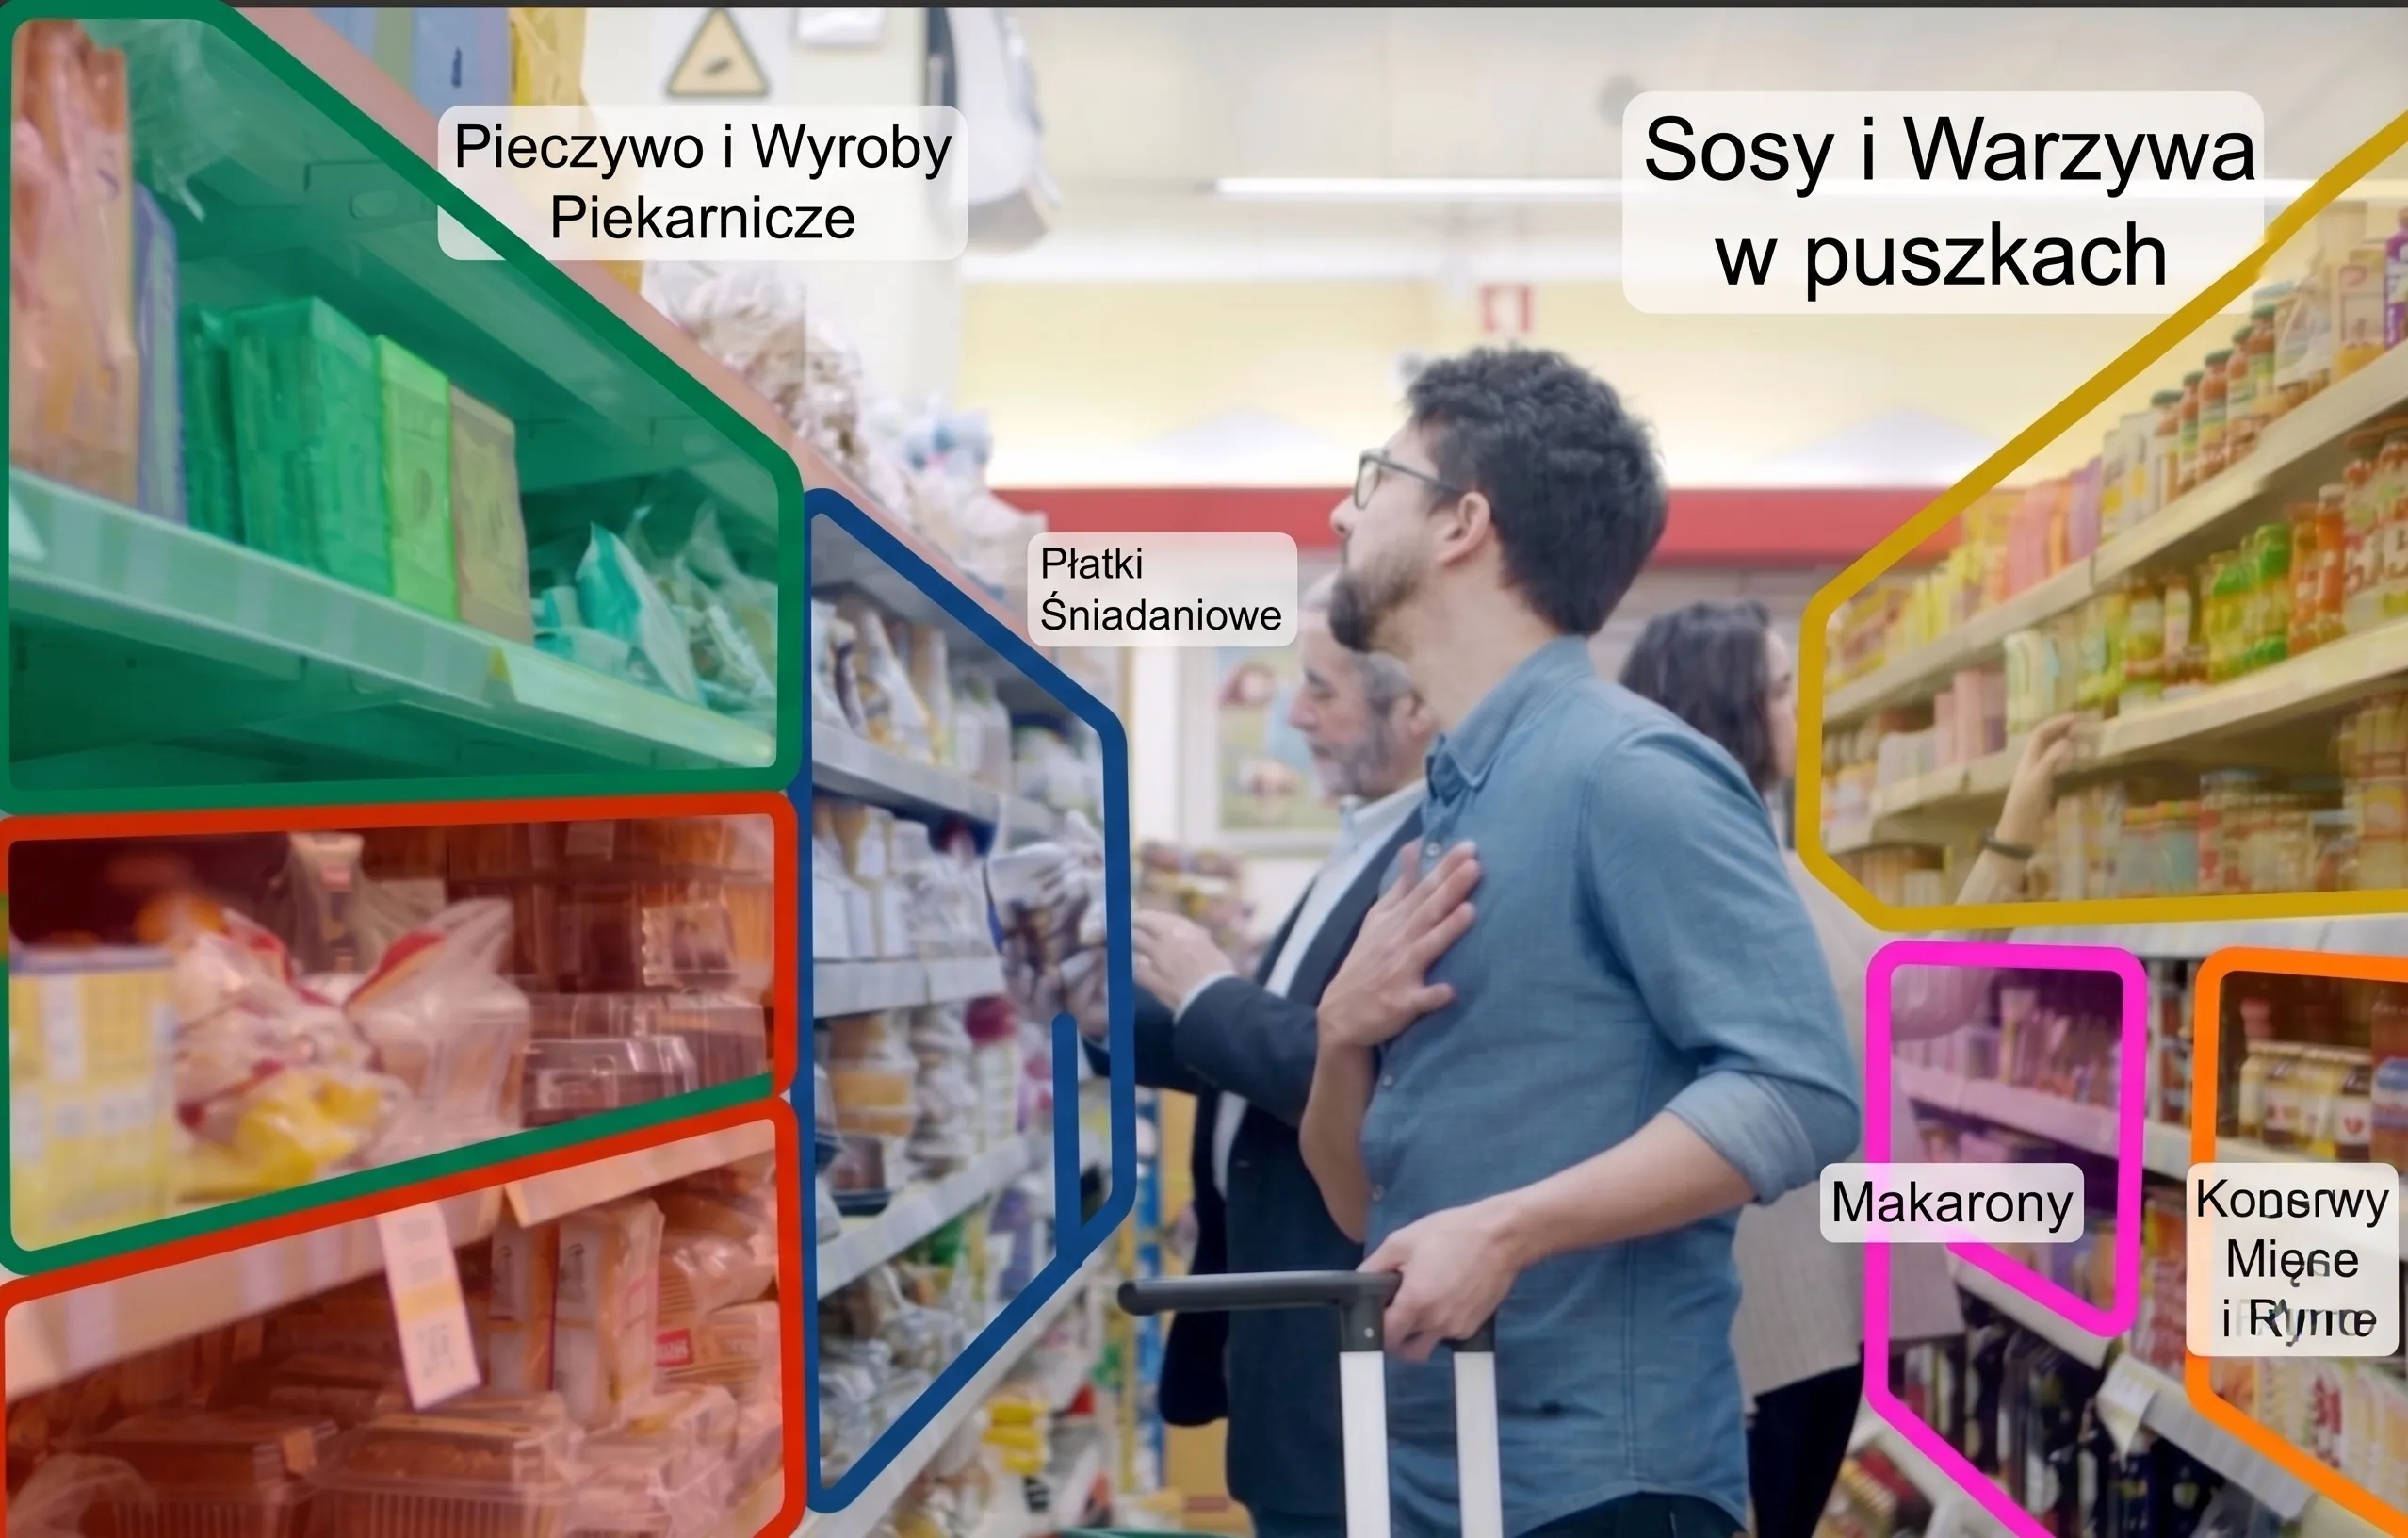
Dla każdej sylwetki powstaje ten sam zestaw danych: czas obecności, strefa, w której się zatrzymała, liczba pobrań i kolejność zdarzeń.
| Osoba w kadrze | Czas w kadrze | Strefa | Pobrania | Przebieg |
|---|---|---|---|---|
| Mężczyzna w niebieskiej koszulipierwszy plan | 00:00 do 00:14 | Płatki śniadaniowe | 1 |
|
| Mężczyzna w garniturzedrugi plan | 00:00 do 00:14 | Pieczywo i wyroby piekarnicze | 1 |
|
| Kobieta w swetrzetrzeci plan | 00:00 do 00:09 | Sosy i warzywa w puszkach | 0 |
|
Ostatnia kolumna zawiera odczyt z obrazu. Nie jest to relacja uczestnika: zapis „trzyma opakowanie stroną z opisem do siebie” opisuje pozycję rąk przez siedem sekund. O tym, czy opis został przeczytany i zrozumiany, rozstrzyga pomiar okulograficzny albo rozmowa po zakupach.
Przykład pokazuje sposób odczytu na jednym ujęciu. Nie jest wynikiem projektu badawczego: w badaniu kadr ustawiamy pod konkretną ekspozycję, a zestawienia obejmują cały okres rejestracji.
Każdy etap kontaktu z ekspozycją ma własną miarę na wspólnej bazie. Spadek między etapami wskazuje miejsce, w którym kontakt się urywa: materiał nie zatrzymuje, opakowanie nie skłania do sięgnięcia albo decyzja przerywa się już po wzięciu produktu do ręki.
Z takiego zestawienia odczytuje się przede wszystkim proporcje między kolejnymi etapami. W szczycie popołudniowym przy ekspozycji zatrzymuje się najwięcej osób, a udział tych, którzy kończą włożeniem produktu do koszyka, rośnie wolniej niż samo natężenie ruchu. Przyczyny tej różnicy nie da się ustalić z zapisu z kamery; wymaga ona pomiaru okulograficznego albo rozmowy z kupującym.
Widoczność pojedynczego nośnika nie wymaga analizy całego sklepu. Wystarczy moduł kamery przy ekranie albo ekspozycji, liczący kontakty i czas uwagi w polu widzenia nośnika. Ten sam schemat obsługuje ekran cyfrowy, stojak i strefę promocyjną, więc wszystkie nośniki trafiają na jedną skalę porównawczą.
Wartości ilustracyjne. Udział liczony w obrębie jednej strefy sklepu.
W formacie convenience demografia wyjaśnia niewiele. Ta sama osoba rano kupuje kawę w pół minuty, w południe składa lunch, a wieczorem uzupełnia kolację. Segmentujemy więc wizyty, a profil odbiorcy i porę dnia nakładamy dopiero na rozpoznaną misję.
Wnioskowanie wrażliwych cech osoby z obrazu, w tym poglądów, wyznania i orientacji, jest zakazane w regulacji europejskiej i nie wchodzi do rozwiązania. Zakres dopuszczalny obejmuje klasyfikację stylu ubioru i kontekstu wizyty na poziomie zagregowanym: strój roboczy, sportowy, szkolny, wieczorowy. Pozwala to różnicować ofertę w ciągu doby bez kategoryzacji biometrycznej.
Zatrzymanie w strefie nie jest dowodem uwagi w sensie poznawczym. Z zapisu z kamery odczytuje się pozycję ciała, tor przejścia i ruch rąk. Kierunek spojrzenia pozostaje poza zakresem tej rejestracji, więc rozróżnienie między wariantem obejrzanym a pominiętym w obrębie jednej półki wymaga pomiaru okulograficznego.
Analiza obrazu opisuje zatem skalę i kontekst: liczbę osób, strefy, w których się zatrzymały, oraz zdarzenia przy półce. Przebieg percepcji opisuje okulografia, prowadzona na mniejszej próbie uczestników. Obie rejestracje synchronizujemy na wspólnej osi czasu, co pozwala zestawiać ich wyniki.
Pierwsza faza trwa sześć tygodni i kończy się raportem. Obejmuje dobór dwóch kontrastowych lokalizacji, inwentaryzację istniejących kamer, kalibrację stref oraz audyt zgodności rozpoznanych zdarzeń z obserwacją prowadzoną przez człowieka. Ten audyt rozstrzyga, które moduły mają w danym sklepie wystarczającą trafność, i od niego zależy zakres dalszych prac.
Kolejne fazy ustalamy po pilotażu: objęcie pomiarem nośników reklamowych i wspólna skala ich porównania, a następnie stały pomiar w panelu sklepów z integracją danych kasowych i planogramu.